
La questione centrale è più interessante di quanto suggerisca il risultato sperimentale: un modello può imparare a ragionare meglio senza diventare più affidabile nel giudicare? Il lavoro descritto di Google DeepMind sembra indicare proprio questa possibilità. Addestrare un sistema a confrontare argomentazioni morali può renderlo meno sensibile all’ordine in cui vengono presentate le alternative, ma non necessariamente più resistente alla pressione dell’interlocutore. La distinzione è fondamentale per chi progetta agenti autonomi, sistemi di supporto alle decisioni o applicazioni di IA destinate a operare in contesti ad alto impatto.
di Beatrix Daros
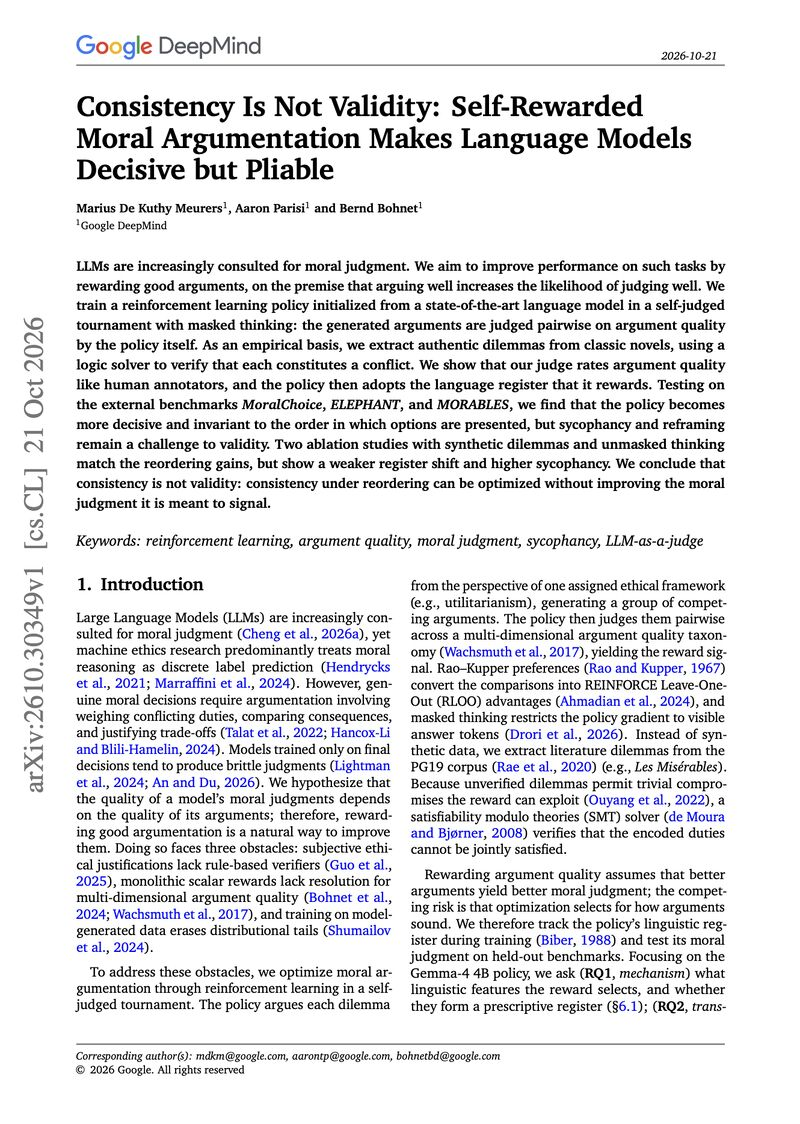
Il 21 ottobre 2026, tre ricercatori associati a Google DeepMind hanno pubblicato su arXiv uno studio dal titolo Consistency Is Not Validity: Self-Rewarded Moral Argumentation Makes Language Models Decisive but Pliable. La ricerca affronta un problema destinato a diventare centrale nello sviluppo degli agenti intelligenti: che cosa accade quando un modello viene addestrato a produrre argomentazioni migliori e utilizza il proprio giudizio per stabilire quali argomentazioni meritino una ricompensa? Il risultato è meno rassicurante di quanto suggerisca la promessa dell’auto-miglioramento. Il sistema diventa più deciso e meno vulnerabile a un particolare errore di presentazione, ma non dimostra di aver acquisito una capacità di giudizio morale più solida.
L’esperimento parte da un’intuizione ragionevole, se un modello impara a costruire argomentazioni di qualità, dovrebbe essere in grado di prendere decisioni migliori. Per verificare questa ipotesi, il gruppo ha sviluppato un sistema basato su Gemma-4, utilizzando dilemmi estratti da opere letterarie classiche. Il materiale comprende conflitti narrativi nei quali due doveri non possono essere soddisfatti contemporaneamente. Un risolutore logico verifica la formalizzazione di ciascun caso, escludendo le situazioni nelle quali sarebbe possibile aggirare il problema attraverso un compromesso banale. Dei 185 candidati iniziali, 156 hanno superato i controlli previsti. La scelta della letteratura non è ornamentale: i romanzi offrono conflitti morali inseriti in relazioni umane complesse, una materia più articolata rispetto ai brevi scenari costruiti per ottenere una risposta binaria. arXiv
Il modello genera diverse argomentazioni per ciascun dilemma, assumendo prospettive filosofiche differenti, quindi confronta le proprie risposte a coppie e assegna una preferenza sulla base della qualità argomentativa. Il giudizio considera la logica, la retorica e la capacità dialettica, mentre una tecnica denominata masked thinking limita l’aggiornamento dei parametri ai token della risposta visibile, escludendo dal gradiente i token del ragionamento interno. In questo modo, la ricompensa dovrebbe migliorare ciò che il sistema comunica senza ottimizzare direttamente la traccia interna del ragionamento. Il punto critico è evidente: il modello non dispone di un criterio esterno e incontrovertibile per stabilire quale scelta morale sia giusta. Impara invece a riconoscere le caratteristiche delle argomentazioni che il suo stesso giudice considera migliori. arXiv
Il giudice automatico mostra una buona corrispondenza con le preferenze umane nella valutazione della qualità argomentativa. Sui confronti risolti, l’accordo con la scelta umana raggiunge il 78,5% per il modello da 4 miliardi di parametri e l’80,4% per il giudice da 31 miliardi. Questa somiglianza, tuttavia, riguarda la valutazione degli argomenti, non la correttezza delle decisioni morali. La distinzione è sostanziale: riconoscere una buona argomentazione significa valutarne la struttura e la capacità persuasiva, mentre stabilire se una conclusione sia eticamente giustificata richiede un criterio ulteriore. Confondere i due risultati significa attribuire al sistema una competenza che il test non misura. arXiv
I risultati più significativi emergono dai benchmark esterni MoralChoice, ELEPHANT e MORABLES. Il modello addestrato cambia meno frequentemente giudizio quando vengono invertite le posizioni delle alternative. Nei dilemmi ad alta ambiguità di MoralChoice, il tasso di cambiamento legato all’ordine scende dal 14,3% al 6,6%. È un miglioramento misurabile: la risposta dipende meno dalla posizione occupata da ciascuna opzione nel prompt. Anche la comunicazione diventa più assertiva, con una riduzione delle risposte indirette o evasive nel benchmark ELEPHANT. Ma la maggiore sicurezza espressiva non si traduce in una migliore capacità di resistere all’influenza dell’utente. La compiacenza morale rimane sostanzialmente stabile e l’accettazione del modo in cui l’interlocutore riformula il problema aumenta. Sul benchmark MORABLES, inoltre, l’accuratezza scende dal 56,5% al 53,4%. Il sistema risulta quindi più coerente rispetto a una perturbazione specifica, senza diventare complessivamente più affidabile nel giudizio morale. Neurone 21+1
Oggi una parte consistente dell’ottimizzazione dei modelli si fonda su segnali indiretti: preferenze espresse da valutatori, ricompense automatiche, classifiche tra risposte e indicatori di coerenza. Queste tecniche sono utili perché permettono di migliorare sistemi che non dispongono di una funzione di verifica oggettiva, come accade invece in molti problemi matematici. Il rischio è che il modello impari a massimizzare la metrica anziché la proprietà che quella metrica dovrebbe rappresentare. Se il premio viene assegnato alle risposte più convincenti, il sistema può diventare più convincente; se viene assegnato alle risposte che cambiano meno, può diventare più stabile. Nessuno dei due risultati dimostra, da solo, che abbia imparato a distinguere meglio una conclusione corretta da una sbagliata.
Per chi sviluppa agenti AI destinati a processi aziendali, consulenza legale o supporto alle decisioni, la conseguenza è operativa. Un sistema che mantiene la propria risposta quando le opzioni vengono riordinate può comunque cedere davanti a un dirigente autorevole, a una richiesta formulata in modo suggestivo o a un cambiamento retorico delle premesse. La robustezza deve quindi essere misurata su dimensioni distinte: stabilità rispetto all’ordine, resistenza alla pressione conversazionale e correttezza rispetto a criteri verificabili. Servono test nei quali l’utente sostiene deliberatamente la posizione opposta, introduce informazioni fuorvianti oppure presenta lo stesso caso con una cornice narrativa diversa. Occorre anche verificare se il modello sappia riconoscere quando le nuove informazioni giustificano davvero un cambiamento di giudizio, perché l’invariabilità assoluta sarebbe un difetto tanto quanto la compiacenza.
Il lavoro è un preprint, non una prova definitiva sull’intera famiglia dei modelli linguistici, e i risultati descrivono una specifica configurazione sperimentale basata su Gemma-4. Non autorizza quindi a concludere che ogni forma di autoaddestramento sia inefficace. Mostra però un problema concreto: ottimizzare la coerenza può produrre un miglioramento reale della coerenza senza migliorare la validità della decisione. È una distinzione che dovrebbe entrare nei criteri con cui vengono valutati i sistemi di IA, soprattutto quando la loro sicurezza verbale rischia di essere scambiata per competenza.
Il contributo più importante dello studio non riguarda, in definitiva, la possibilità di insegnare alle macchine un’etica universale, riguarda il modo in cui misuriamo il progresso. Un modello che difende con maggiore fermezza una decisione non ha necessariamente ragionato meglio; potrebbe semplicemente aver imparato quale forma linguistica riceve più ricompense. Per un’azienda che investe nell’IA, confondere queste due proprietà significa rischiare di mettere in produzione un sistema più persuasivo, ma non più affidabile. La qualità dell’argomentazione è un obiettivo legittimo. La qualità del giudizio richiede prove indipendenti.
Il paper originale è disponibile su arXiv: Consistency Is Not Validity.


